Perché alcune pagine del sito non vengono indicizzate da Google
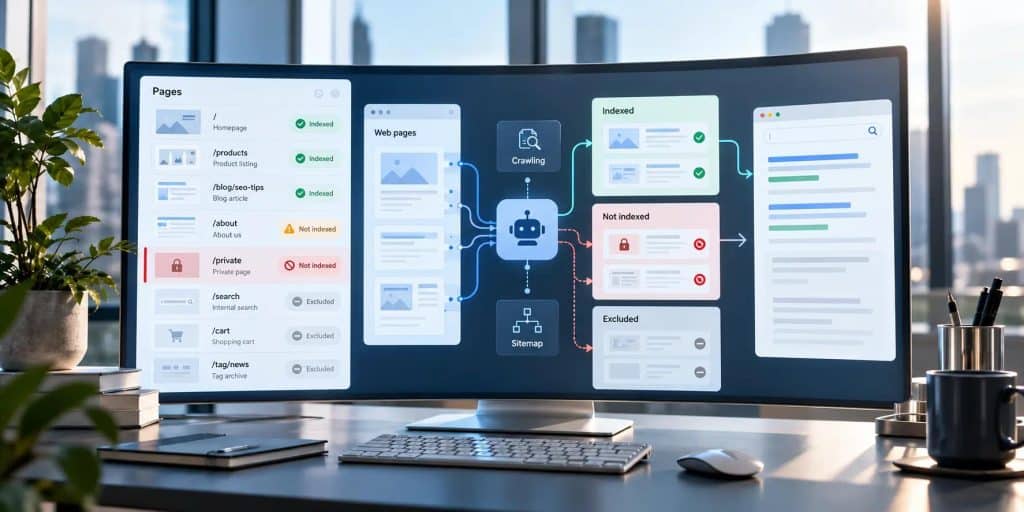
Una pagina pubblicata e raggiungibile dal browser non è automaticamente una pagina indicizzata. Google deve prima scoprirla, poterla scansionare, ricevere una risposta valida, interpretarne i segnali tecnici e considerarla sufficientemente utile e distinta da inserirla nell’indice.
In breve |
Indicizzazione: prima di tutto bisogna capire dove si blocca il processo
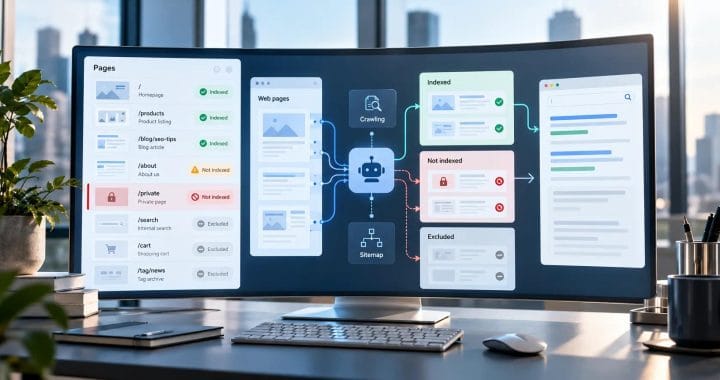
La sequenza è semplice solo in apparenza: Google scopre una URL, prova a scansionarla, ne elabora il contenuto e decide se indicizzarla. Una pagina può quindi essere conosciuta ma non ancora scansionata, scansionata ma non indicizzata, oppure esclusa perché Google considera un’altra URL come canonica.
Per questo la frase “Google non indicizza la pagina” non descrive un solo problema. È necessario leggere lo stato specifico in Search Console e verificare la singola URL con lo strumento Ispezione URL.
Segnale | Cosa può significare | Controllo prioritario |
Bloccata da robots.txt | Googlebot non può scansionare normalmente la risorsa. | Regole robots e accessibilità reale. |
Esclusa da noindex | La pagina può essere scansionata ma non deve entrare nell’indice. | Meta robots o X-Robots-Tag. |
Duplicata / canonical alternativa | Google preferisce un’altra URL come versione principale. | Canonical dichiarata, linking interno, sitemap e duplicazioni. |
Scansionata, non indicizzata | Google ha visto la pagina ma non l’ha inserita nell’indice. | Qualità, unicità, intent, soft 404, rendering e segnali interni. |
Scoperta, non scansionata | La URL è nota ma la scansione non è ancora avvenuta o è poco prioritaria. | Link interni, sitemap, dimensione del sito e qualità complessiva. |
Errore 4xx/5xx | La pagina non restituisce una risposta 200 valida. | Status HTTP e stabilità server/applicazione. |
Robots.txt e noindex non sono la stessa cosa
Un errore frequente è usare robots.txt per impedire l’indicizzazione. Il file robots.txt serve principalmente a controllare la scansione; non è il meccanismo corretto per garantire che una pagina non compaia nei risultati. Per escludere una pagina dall’indice si utilizza invece noindex, a condizione che Google possa scansionare la pagina e leggere quella direttiva.
La combinazione sbagliata può creare situazioni paradossali: se una URL è bloccata in robots.txt, Google potrebbe non riuscire a vedere il noindex presente nel codice. Per le pagine che si vogliono indicizzare, invece, bisogna verificare che non esistano direttive ereditate da staging, template o plugin.
BitHub tratta questi casi come problemi di architettura e non come semplici “richieste di indicizzazione”. Nel servizio SEO tecnico di BitHub rientrano proprio Search Console, sitemap, canonical, pagine escluse, URL, filtri e struttura interna: segnali che devono essere letti insieme per capire perché Google sta ignorando o sostituendo una pagina.
La canonical può indicare una pagina diversa da quella che volevamo
Quando più URL hanno contenuti identici o molto simili, Google può raggrupparle e scegliere una versione canonica. Il tag rel=”canonical” è un segnale importante, ma non è un ordine assoluto: redirect, sitemap, link interni e contenuto possono portare Google a scegliere un’altra URL.
Se la pagina A dichiara se stessa come canonica ma tutti i link interni puntano alla pagina B, oppure la sitemap contiene solo B, il sistema riceve segnali contraddittori. In questi casi la soluzione non è aggiungere canonical a caso, ma rendere coerenti tutti i segnali.
Sitemap e linking interno: essere presenti non basta, ma aiuta
Una sitemap XML comunica quali URL il sito considera importanti, ma non garantisce l’indicizzazione. Lo stesso vale per la richiesta manuale in Search Console: può accelerare la scoperta o il controllo, non obbliga Google a inserire la pagina nell’indice.
Il linking interno è spesso più rivelatore. Una pagina raggiungibile solo dalla sitemap, senza collegamenti interni significativi, comunica una priorità diversa rispetto a una risorsa integrata nella navigazione, collegata da categorie e contenuti pertinenti. Per gli eCommerce, questo aspetto è particolarmente importante per categorie, brand e filtri selezionati per l’indicizzazione.
“Scansionata ma non indicizzata”: quando il problema è il valore della pagina
Se Google può accedere alla pagina, riceve un 200, non trova noindex e non rileva un errore tecnico evidente, la causa può essere qualitativa o strutturale. Pagine quasi vuote, duplicazioni, risultati di ricerca interni, filtri senza domanda reale o schede molto simili possono non offrire abbastanza valore distintivo.
Non significa che esista una soglia minima di parole. Una pagina breve può essere perfettamente utile; una pagina lunga può essere ridondante. Il punto è se risponde a un intento riconoscibile, aggiunge informazioni originali e occupa un ruolo chiaro nell’architettura del sito.
Attenzione ai soft 404
Una pagina può restituire HTTP 200 e contemporaneamente mostrare un contenuto che, per Google e per l’utente, equivale a “non trovato”: per esempio una scheda prodotto vuota, una pagina senza contenuto principale o un risultato di ricerca interno privo di risultati. In questi casi Search Console può segnalare un soft 404 e la pagina viene esclusa.
Se il contenuto non esiste più e non c’è un sostituto, Google raccomanda un vero 404 o 410. Se invece esiste una nuova destinazione equivalente, è più corretto utilizzare un redirect permanente.
Un metodo pratico di diagnosi
Per ogni URL importante conviene procedere in ordine: verificare status HTTP; controllare robots e noindex; leggere canonical dichiarata e canonical scelta da Google; verificare che la pagina sia nella sitemap corretta; controllare i link interni; confrontare il contenuto con eventuali duplicati; infine valutare rendering, qualità e utilità.
Questo metodo evita un errore comune: chiedere ripetutamente l’indicizzazione di una pagina senza correggere la causa che porta Google a escluderla.
Indicizzare meno, ma meglio
L’obiettivo di un sito non dovrebbe essere far indicizzare ogni URL generata dal CMS. Filtri, parametri, pagine di ricerca e varianti possono moltiplicare il numero di URL senza aumentare il valore del sito. Una buona strategia decide quali pagine meritano di essere indicizzate e rende coerenti struttura, contenuti e segnali tecnici intorno a quelle risorse.
Domande frequenti
Inviare una URL in Search Console garantisce l’indicizzazione?
No. L’ispezione URL può richiedere una nuova scansione, ma Google non garantisce che una pagina venga indicizzata.
Una pagina bloccata da robots.txt può essere indicizzata?
L’URL può in alcuni casi comparire comunque se Google la conosce da link esterni o interni, ma il contenuto non viene normalmente scansionato. Robots.txt non è il metodo corretto per imporre la non indicizzazione.
Quanto conta la sitemap?
È un segnale utile per la scoperta e per comunicare le URL considerate importanti, ma non sostituisce linking interno, qualità e coerenza tecnica.
Fonti e approfondimenti
• Google Search Central – Technical requirements
• Google Search Central – Block indexing with noindex
• Google Search Central – How Google Search works